比较音频版本时,码率只能提供部分信息。以鼓点前可能出现的预回声为线索,文章解释压缩误差如何分布、耳朵为何对声音前后区别对待,以及编码器怎样处理突发声音,并给出可操作的试听方法。
下载同一首歌时,两个版本标着不同码率,你会直接选数字更大的那个吗?如果想知道增加的数据有没有带来可听的改善,可以先找一段安静之后突然落下的鼓点,留意鼓声响起前有没有多出细碎杂声。
剪辑一段响板或烟花录音时,你也可能关心另一个问题。原始声音的起头很利落,压缩后为什么像提前多出了一点动静?这种变化可能与编码误差出现的时刻有关。沿着声音进入编码器、再被还原的路径,就能理解码率数字为何不足以独自回答听感问题。
码率给出预算,编码还要决定怎么用
码率表示每秒用于表示音频的数据量。这里讨论会引入误差的有损编码。在同一编码方法下,提高码率通常能放宽数据预算,让声音成分得到更精细的表示。但预算如何分配,也会影响最终留下哪些可听变化。
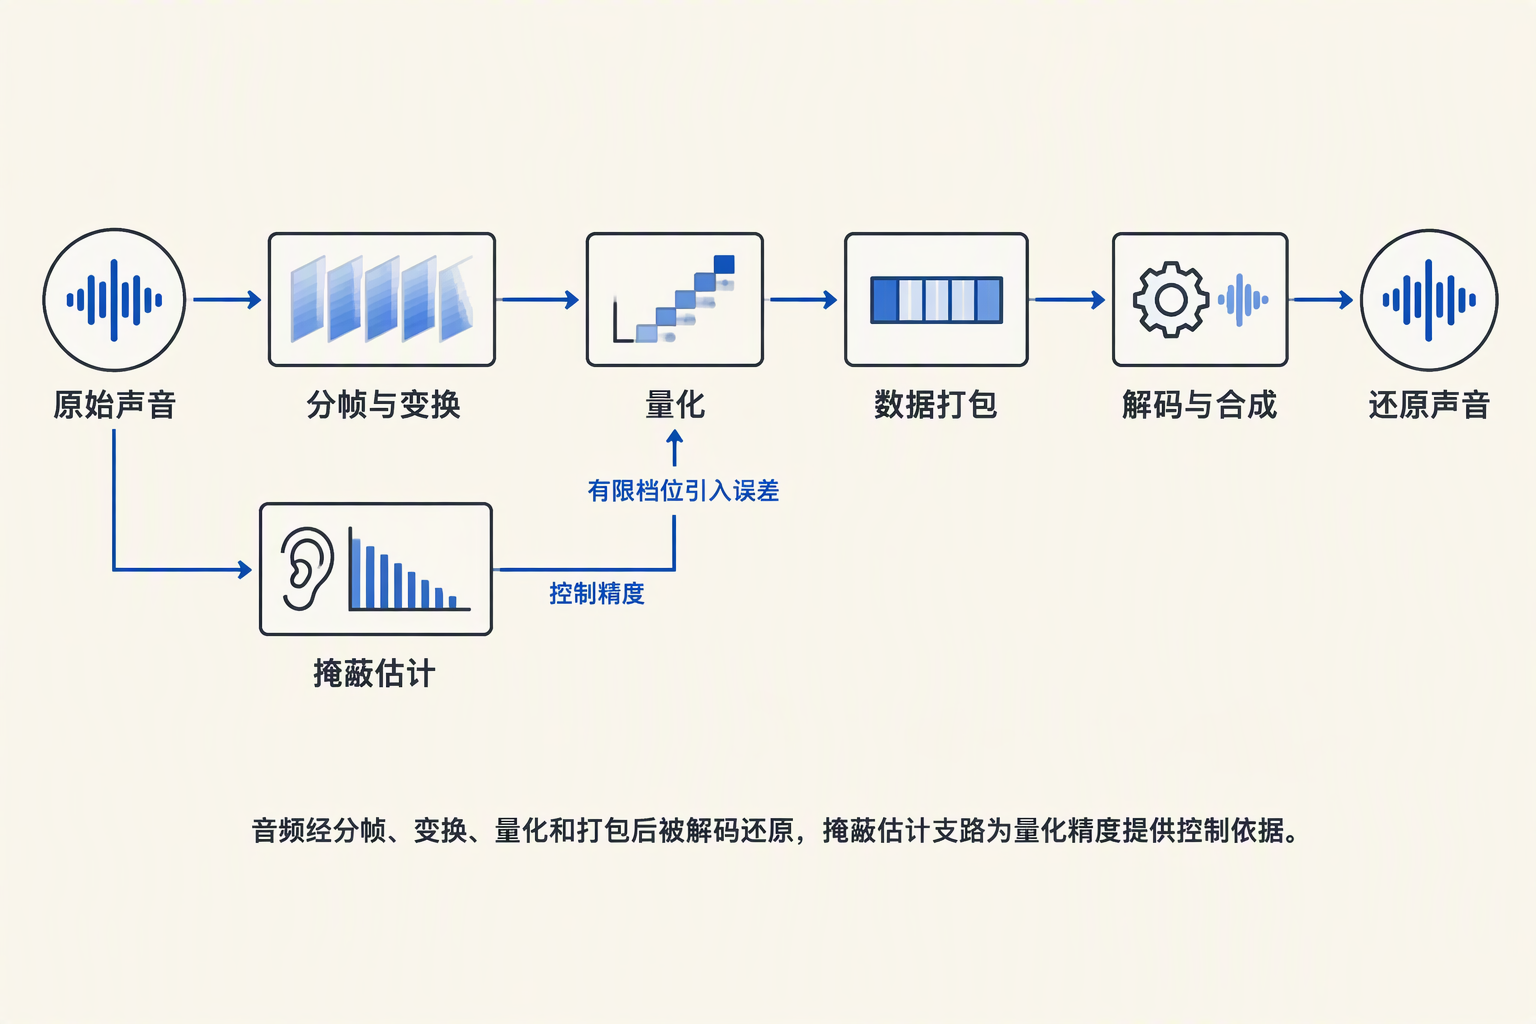
以变换编码为例,编码器先把声音分成短片段,再把片段表示成一组对应不同时间和频率范围的成分。频率描述振动快慢,与声音的高低有关。这一步为后续处理提供了条件,让不同成分可以采用不同的表示精度。
随后进行量化,也就是用有限的数值档位近似表示这些成分。档位变粗可以节省数据,同时引入量化误差,常被称为量化噪声。数据打包后交给解码器,解码器恢复量化后的成分,再合成为声音。误差会随这条路径进入还原信号,它能否被听见,还取决于原声的遮盖作用。
鼓点能遮住多少误差,要看前后时刻
听觉掩蔽指一个声音使另一个声音变得难以听见。原声与量化噪声同时出现时,原声可能遮住邻近频率范围的噪声。编码器中的心理声学模型,就是用计算方法估计这种遮盖能力,帮助判断哪些位置需要更高精度。
这种遮盖还与时间有关。一个声音结束后,听觉对随后弱声音的敏感程度可能暂时降低,这叫前向掩蔽。对编码而言,强声之后的一小段时间,可能容许更多误差。具体可容许多少,需要结合声音变化与模型判断,不能把强声后的整段安静都视为可以随意添加噪声的区域。
强声出现之前,情形有所不同。尚未响起的鼓点,对前面弱声音的遮盖通常很有限。因此,相似的误差放在鼓点之前或之后,可能有不同的可听程度。只根据一段声音包含多少高低频能量来分配精度,就可能忽略这种前后差异。
预回声怎样进入鼓点前的安静
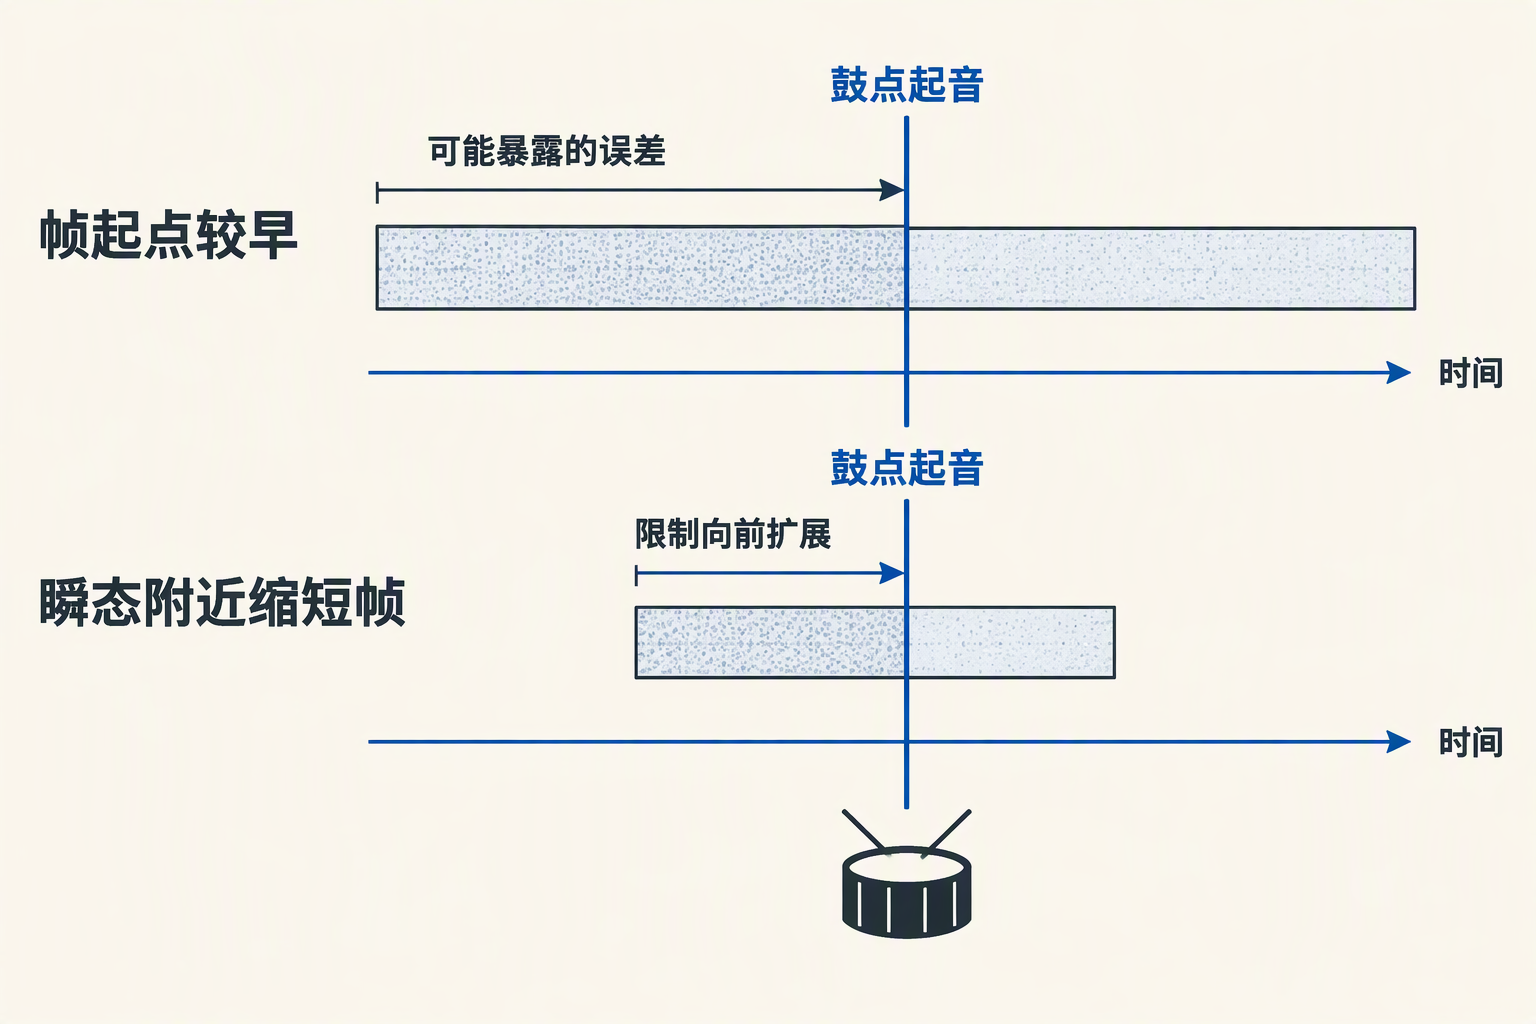
编码器处理的短片段称为帧。某些变换编码方式产生的量化噪声会分布在整帧内,而鼓点可能只占帧的后半部分。这样一来,误差就可能落到鼓点真正开始之前,进入原本较安静的位置。
这类出现在突发声音之前的编码失真称为预回声。这里的突发声音也叫瞬态,指起音等快速变化的部分。预回声可能让起音前多出可察觉的噪声,使声音边界显得不够干净。它由编码过程引入,与房间里声波反射形成的回声机制不同,也不要求出现一遍清晰重复的鼓声。
一种处理办法是先检测瞬态,再调整分帧,在瞬态附近使用更短的帧,让帧的起点靠近起音,限制噪声向前铺开的范围。另一层处理是把时间上的掩蔽差异纳入误差评估,再据此分配精度。这些步骤都需要编码器作出判断,提高总码率本身无法说明它采用了怎样的判断。
比较听感,先固定条件再听具体位置
在一种简单变换编码器中,同时考虑频率和时间掩蔽的模型,在相近码率下获得了比仅考虑频率掩蔽的模型更好的听音评分。对应条件是单声道、44.1千赫采样率,以及32和48千比特每秒两个目标码率,实际平均码率略低于目标。它支持编码决策会影响质量,不能据此判断所有设备上的高低码率胜负。
这些比较覆盖了10段素材,由9名听者在隔声房间内通过耳机完成。换成立体声、其他编码器或不同播放条件,需要重新判断。鼓点前出现杂声,也只能作为值得检查的线索;如果原始录音本来就有类似声音,仅凭这一处听感无法认定发生了预回声。
自己观察时,可以从同一份原始音频生成不同码率版本,保持编码器和其他设置一致。选取安静后出现鼓点、响板或其他清楚起音的短段,保留起音前后的声音。试听时使用相同设备,关闭额外音效并尽量匹配响度,先比较起音前的安静,再听起音是否清楚、尾部是否自然。
最后把版本名称隐藏,打乱顺序,重复比较,并记下每次察觉差异的具体位置。如果无法稳定辨认,就记录为当前片段和条件下未能稳定分辨;如果能辨认,再对照原始音频确认变化。这样的结果更能回答你实际听到了什么,也让码率数字获得清楚的使用边界。