我干这行有些年头了,最怕听见一句话:“数据测完了,接下来得靠耳朵调。”说这话的人通常一脸虔诚,好像“耳朵”是什么通灵术。你问他耳朵凭什么比麦克风准,他跟你讲经验;你问他经验能不能复现,他跟你讲艺术;你问他艺术有没有边界,他就不说话了。
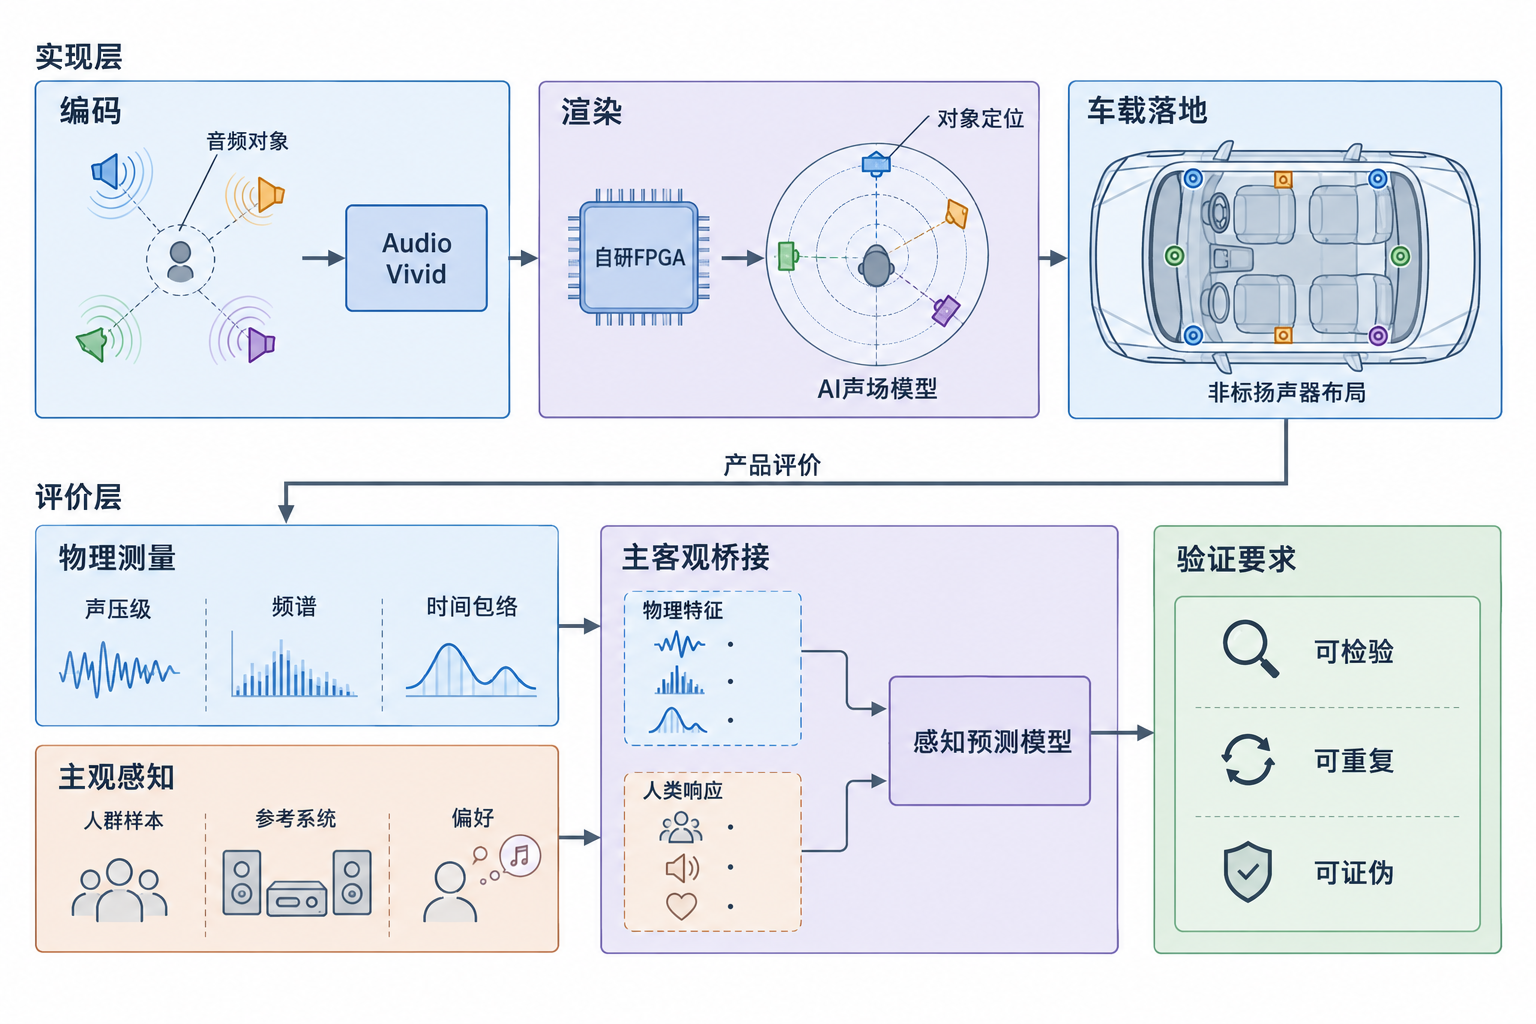
赛因做Audio Vivid,手里攥着这个标准一半以上的发明专利,四十多项,从编码到渲染到车载落地,链路是通的。按说标准自主了,该扬眉吐气了吧?没有。因为行业里大多数人,包括很多用着我们标准的团队,验收产品的时候还是老一套:仪器测个频响,然后请“金耳朵”来听,听完点头,就算好了。金耳朵说不行,你数据再漂亮也得改。这事儿怪就怪在,没人觉得怪。
DCI那套东西是明着收钱。一张认证,中国影院替好莱坞守了二十年门。好莱坞片子在国内票房占多少?个位数。但为了这个个位数,百分之百的影院得跪着。华夏利亚德那个谢鸣赫说过一句大实话:技术标准国外定义,产品中国生产,应用中国最大。这不是技术,这是收租。华为推HDR Vivid的时候说不收费,画质还提升三成,运维降两成,中影的CINITY LED指标超了DCI现行标准,也拿了DCI最高认证。路是通的。不走,是因为有人靠旧路活着。
但DCI好歹看得见。看不见的那层在ITU-R。BS.1116、BS.1534,这些编号行业里没人陌生。它们规定了怎么听、听什么、几个人听、在什么屋子里听、听完怎么打分。这套东西诞生的时候,大家还在跟立体声编码的细微瑕疵较劲。现在音频都对象化、沉浸式了,听音环境从消声室变成了行驶中的车厢和乱糟糟的客厅,这套方法的底子已经松了。国际学界自己都在吵要不要混合方法。可国内呢?一个产品不在那套量表上拿到“显著偏好”,就不算“做好”。谁定的?没人问。
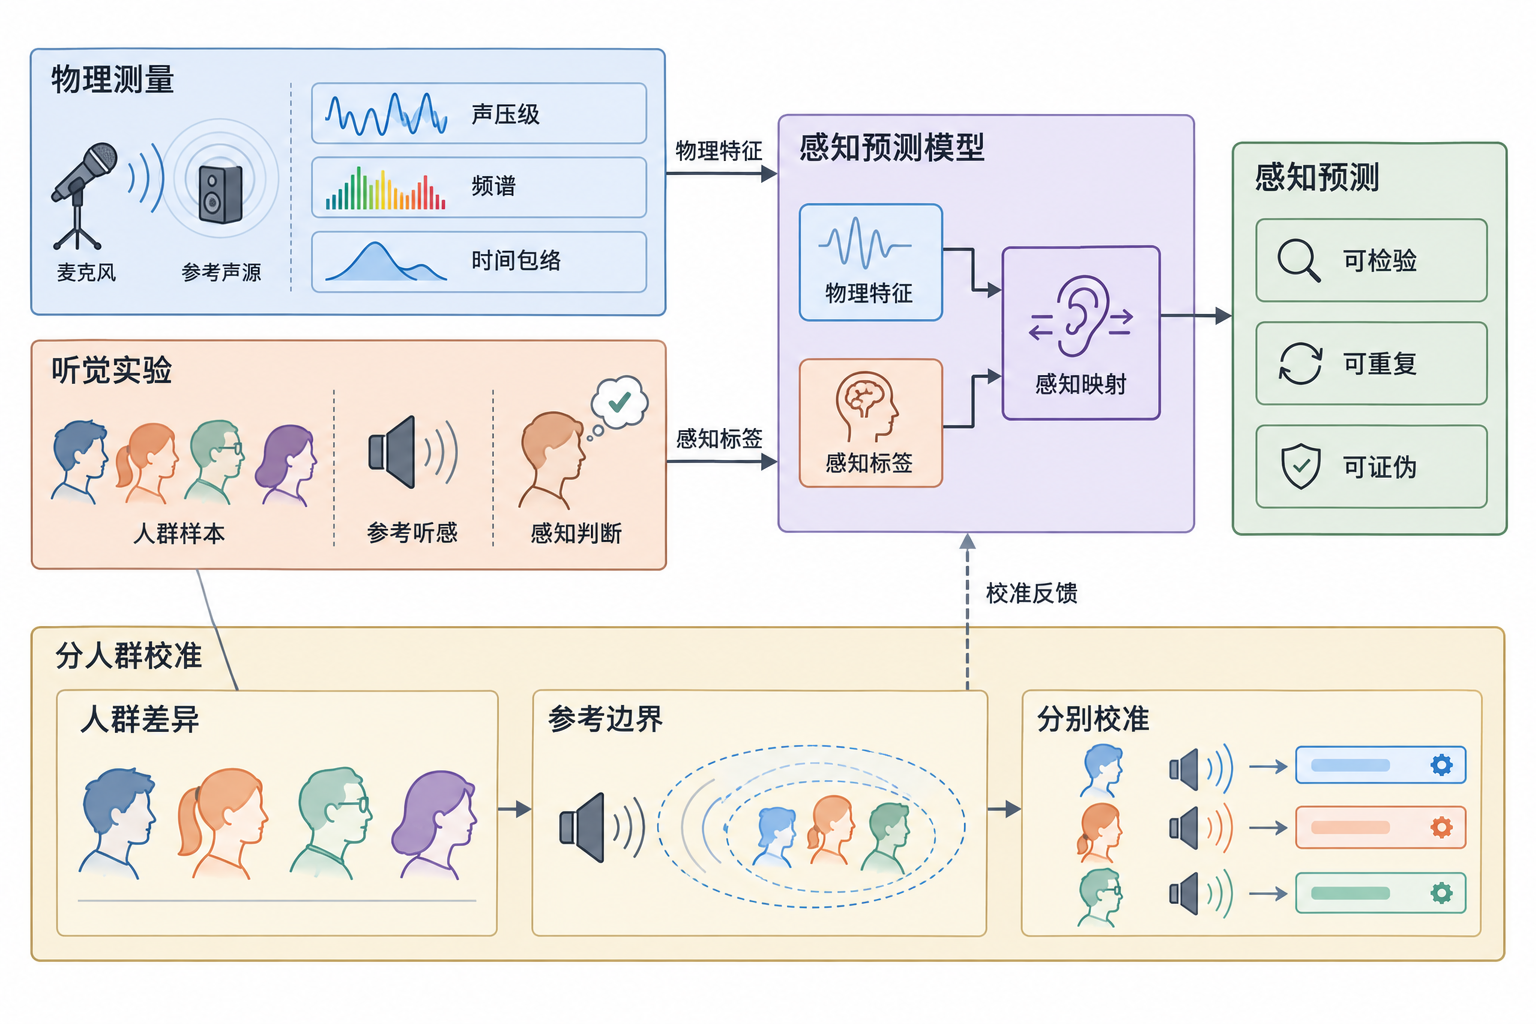
更邪门的是“金耳朵”。心理声学本来干的就是搭桥的活儿:把声压级、频谱、时间包络这些能测的东西,跟人耳听到什么,用可重复的模型连起来。桥两头都是硬的。但行业里流行的是把桥拆了,直接让金耳朵飞过去。汽车音响调音,仪器测完基础频响,金耳朵上场,凭感觉微调,调完说“对了”。有调音师公开讲,AI给的结果技术上正确,但“听起来不一定好”,频谱仪翻译不了他耳朵捕捉的细微之处。还有调音比赛,算法预设的系统输给了人耳调的。听着挺感人,其实是把一种没经过物理检验的判断供上了神坛。金耳朵的耳朵哪来的?特定的训练、特定的参考系统、特定的音乐、特定的偏好。这套东西被制度化成终点,保护的就不是科学,是授权。谁有资格说“好听”,谁就握着不经过测量的裁量权。而这套授权,跟那些卖品牌溢价的西方机构,用的是同一张知识地图。
最精妙的地方在这儿:你可以用自主标准做产品,然后把产品交给一套西方实验室传统里长出来的“金耳朵”叙事去验收。标准的主权拿回来了,判断的主权还在半空悬着。赛因的车载方案,自研FPGA,非标扬声器布局,AI声场模型预训练了近十万种噪声和声场特征,四十毫秒算完,九十dB下功耗三十瓦左右。全国首张双国标菁彩声音响系统测评证书也拿了,从标准、芯片、算法到生态,全栈自主可控。可控的是什么?是实现层。声场怎么渲染、对象怎么定位、延迟怎么压,这些工程问题中国人做得很好,赛因和同行已经证明了。但渲染完了之后,“好不好听”的最终裁决,有多少还在沿着别人的轨道跑?
还有一层数据,让“金耳朵”的普适性更可疑。中国人群的等响曲线跟西方人群有差异,高频段中国受试者更敏感;跨文化研究也反复看到,响度和舒适度判断在不同文化背景之间有统计学上显著的差别。这不是说谁的耳朵更准,是说以特定人群听觉特征校准出来的“参考听感”,从一开始就没它宣称的那么普适。当一套评价体系默认参考耳朵是通用的,而实际上它只是在某个人群样本上校出来的,那它输出的“好”与“不好”,就同时带了技术判断和文化判断。买办结构最狠的一步,不是逼你承认他们的声音更好,是让你在 accept “什么叫好”的时候,忘了这个定义有出处、有边界、可以被物理测量重新校准。
赛因的位置很清楚:标准层已经证明了中国团队能定义规则。但“最后阵地”之所以叫最后,是因为它不在标准文本里,不在芯片架构里,在判断的语法里。只要“好听”的最终裁决还能被追溯回一套没经过本土物理数据校准的金耳朵传统,只要“声音不能只看数据”还能被拿来给跳过主客观桥接工作打掩护,标准自主拿回来的就只是躯干,不是神经。
心理声学那件本该做完的活儿,得做完。用中国人群的物理测量数据,建可检验、可重复、可证伪的主观感知预测模型。让“好听”变成一个能被测量解释、被数据逼近、被不同耳朵分别校准的变量,而不是一顶从别人那儿继承来的王冠。赛因在标准层拆了一锤。下一锤,得砸在方法层。不然标准自主了,判断还是别人的,那跟以前有什么区别?